LLMは何でも生成しなくていい?【前編】ScaleDown CDMと情報抽出モデルへの期待
ScaleDownのCDM、特に情報抽出モデルExtractに注目し、業務システムやOCRとの組み合わせ、ローカルで動くGLiNERへの期待を紹介します。
Jev以降、「生成しないAI」が面白い
ゼンクエンジニアのすぎもとです。
最近、個人的に注目しているのが、文章を生成することを目的としないAIモデルです。
きっかけの一つは、もちろんみんな大好きTypeSafe AIのJevです。これは意思決定モデルと呼ばれ、一般的なLLMのように文章を次々と生成するのではなく、与えられた状況と選択肢に対して、どの選択肢が適切かを判断することに特化したモデルです。問い合わせをどの担当者に振り分けるか、エージェントが次にどの処理を実行するか、といった判断を高速かつ低コストに実行できます。
こういう分類や判断は従来のLLMでも実現できますが、単に選択肢を一つ決めたいだけなのに、巨大な生成モデルを動かして文章として答えを出力させる必要ないよね? という新しい視点から作られたモデルで、大きなインパクトを生みました。OpenAI、MS や Cloudflare など有名どころも続々と意思決定モデルを発表し、ある種のムーブになりましたよね。
最近は Jev 以外にも、こうした特定の処理に特化したモデルやサービスが登場していて、そもそも文章を生成する必要がない仕事には、もっと適したモデルがあるのではないか という方向性が面白くなってきました。そんな中で気になったのが、ScaleDownが発表した CDM(Constrained Decoding Models) です。
CDM とはなにか?
CDMは、LLMが普段行っている仕事の一部を、専用のモデルで効率よく処理しようというものたちです。ScaleDown では、主に4種類のモデルが用意されています。
| モデル | できること |
|---|---|
| Classify | テキストを指定したカテゴリに分類する |
| Extract | 文章から必要な情報を抜き出す |
| Summarize | 長い文章を要約する |
| Compress | 大量の情報から必要な内容を残して圧縮する |
Classify は Jev に近い用途で、問い合わせの種類を判定したり、複数の選択肢から適切なものを選んだりできます。
Summarize は文章全体を要約、Compress は特定の文脈に沿って文章を圧縮します。どちらも LLM に渡す大量のコンテキストを減らす用途に使えそうで、特に Compress は、エージェントのコンテキスト肥大化を抑える用途として面白そうです。
なお、4モデルすべてが文章生成を行わないわけではなく、Summarize は要約文を生成します。共通するのは、汎用的に何でも生成するのではなく、用途に合わせて処理を特化させるという考え方です。まだ出たばかりなので、実際の精度や速度は用途ごとに検証する必要がありそうですが、どれもなかなか面白そうな技術です。
個人的に一番気になったのは Extract
4種類の中でぼくが特に面白いと感じたのは Extract(情報抽出) です。これは、文章の中から指定した項目に該当する情報を取り出すモデルです。
例えば、次のようなメールが届いたとします。
株式会社ABCの田中です。先日ご相談した件ですが、10月末までに納品をお願いしたいです。予算は50万円程度を考えています。
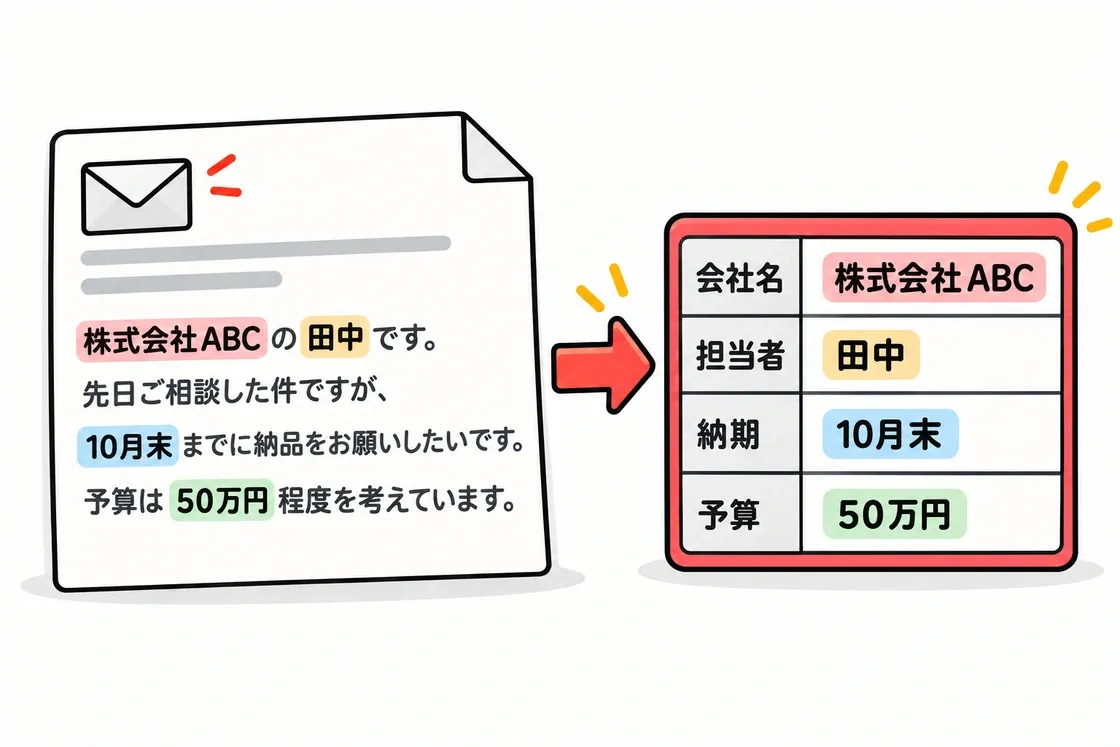
ここから会社名、担当者、納期、予算などを抽出して、構造化データに変換することができます。こういう処理は、実際の業務システムでは非常によく使われます。メールから案件情報を取り出したり、請求書から金額や日付を読み取ったり、自由記述の問い合わせから必要な項目を抜き出したり、、、
もともとは人間がこれを見てエクセルとかに入力してたと思います。弊社でいえばエクセルから kintone になりましたが、結局ぽちぽち入力してました(昔は)。で、最近ではLLMで「次の文章から必要な情報をJSON形式で出力してください」と指示すればなんとなくやってくれるので、ひとによってはエージェントにメール読ませて自動でやったりしてます。ただ、やりたいことは 元の文章のどこに、必要な情報が書かれているのかを知りたいだけ で、「生成AI」を使う必要はないんですよね。
というわけで、その処理に特化したモデルがあれば、汎用LLMよりも効率よく処理できる可能性があるんじゃないか、という思想がこの Extract です。抽出した文字列だけでなく、元の文章中の位置や信頼度なども取得できるのも面白い。業務システムでは、抽出結果が本当に元の文章に書かれていたのかを確認できることも重要なので、これは実用上の利点になりそうです。
よくある業務への構造化データの作成
よくあるのが、OCR から始まる構造データの作成です。これまでも構造化データ作成の大きな障壁が紙の帳票や手書きメモでした。弊社でも製造業様向けのヒアリングをしていると日報や指示書など多くのデータがまだ紙のままです。これ自体は昔からある問題で、 OCR でデータ化して、テキストマイニングで構造化データに変換というやりかたはあります。最近は雑にデータ化したものを構造化データに変換するところは LLM でかなり正確にできるようになったと思います。
ただ、この LLM の部分で毎回高性能なモデルを使うのは、少々オーバースペックな気もします。 Extract に差し替えれば低コストで高速で処理できる可能性がある気がします。必要な部分だけを専用モデルに任せ、判断が難しいものだけ LLM や人間に回せば、精度とコストのバランスが良い仕組みを作れるかもしれません。こうした情報抽出は、一つ一つの処理は地味ですが、業務システムでは非常に需要が大きい領域だと思います。
ローカルでも同じようなことができそう
実はローカルでも動く Extract みたいな技術がすでにあります。GLiNERという情報抽出モデルです。
GLiNERは、あらかじめ決められた人名・地名などだけでなく、ユーザーが指定したラベルに基づいて文章から情報を抽出できるモデルです。従来の自然言語処理で使われてきたNER(固有表現抽出)の技術を、より柔軟に使えるようにしたものと考えると分かりやすいでしょう。
もし小さなモデルをCPUで動かすだけでも、それなりの精度で日本語の情報抽出ができるなら、Extract はいらないのでは? 業務システムに組み込む用途ならローカルで済むなら十分ですよね。実際にどこまで使えるのか、ちょっと試してみたので 後編で、GLiNER2.5をローカル環境で動かし、日本語の自由記述から情報を抽出する実験をしてみます。